
数字AI卷到能自我升级,MirroS推出Physical RSI框架,给物理智能装上永久进化buff
2026年的AI圈早就把 递归自我改进(RSI) 玩明白了,数字世界里的AI堪称不用摸鱼的内卷达人。
就拿Karpathy打造的AutoResearch来说,这AI简直是全自动科研工具人:自己写代码、自己跑对照实验,把能提升效果的优化方案全部留存,循环往复迭代升级,性能一路走高。这套逻辑听着近乎完美,可它藏了个舒适区专属前提——整套系统活在完全可控的数字沙盒里。编译器规则一成不变,评判标准提前锁死,环境没有半点变数,AI只需要埋头打磨行动策略,相当于全程开卷考试,所有已知条件全都摆在台面上。
可一旦把AI丢进真实物理世界,这套丝滑闭环瞬间碎得一干二净。机器狗出门遛弯,没人提前给它一份标注全路面障碍的说明书;工厂机床长年运转零件慢慢磨损,数字孪生模型悄无声息和现实脱节;全自动实验室做实验,时不时蹦出一堆现有理论完全解释不通的奇异数据……现实天地无边无际,环境时时刻刻在变,到处藏着意料之外的突发状况,既没办法全部枚举,也没法冻结静止。就算系统操作失误,也没有数字世界一键清零、零成本重跑的补救按钮。
如今行业还在死磕一条笨路子:疯狂堆砌训练数据,强行拉高模型出厂时的泛化能力,指望AI部署落地后硬扛所有未知意外。可所有人都刻意回避了一个直击灵魂的难题:当AI直面瞬息万变的物理现实,究竟要如何实现落地之后持续自学、越用越强?
MirroS交出了业内第一套完整解决方案,重磅推出Physical RSI全新范式。这也是公开学术资料里,首次有人把递归自我改进的完整逻辑,从封闭数字空间系统性迁移到真实物理场景,从核心概念、运行机制到完整研究路线图一站式配齐,直接填补行业长期空白。
一、数字RSI单向“卷动作”,Physical RSI双线同步进化
想要读懂这套新框架,得先分清数字RSI和物理RSI天差地别的底层逻辑。
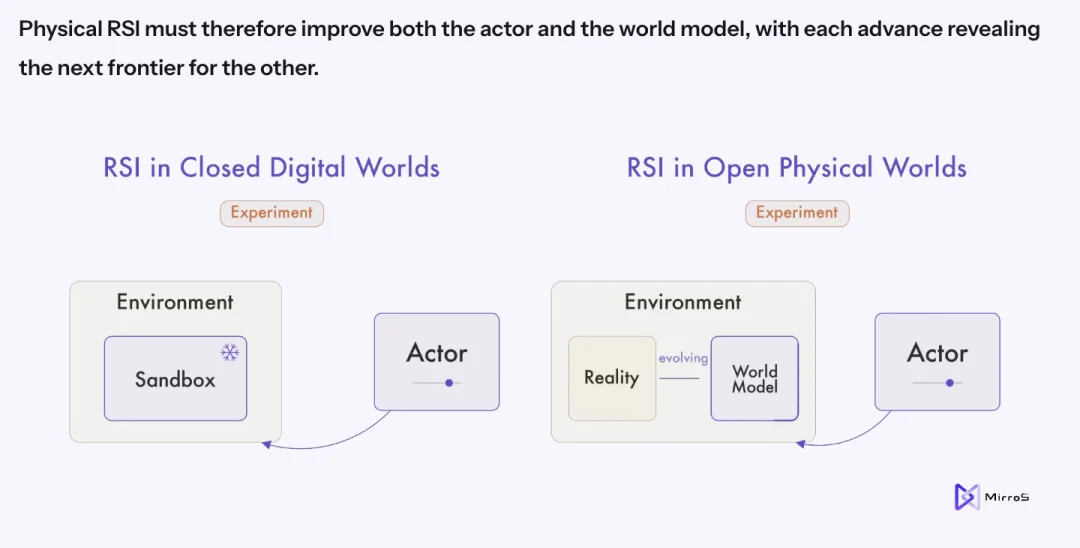
数字世界的RSI是单轴单线进化:环境、规则、打分标准全部固定不变,AI唯一任务就是持续优化自身执行策略,AutoResearch就是典型例子,外部世界纹丝不动,只有AI生成的代码方案在迭代更新。
但物理世界完全是另一套逻辑,周遭环境本身就是一团流动、充满未知的谜题,AI必须不间断学习、建模才能看懂世界。机器狗永远预判不到脚下突然横出一根电缆,工厂控制器没法精准预知机床今日损耗和昨日的细微差别。倘若AI用来认知世界的模型本身漏洞百出,就算动作策略打磨得再行云流水,也只是建立在错误地基上的空中楼阁,优化得越精细,偏离真实情况越严重。
这便是MirroS最颠覆性的核心洞察:Physical RSI必须实现执行智能体Actor与世界模型World Model双轴耦合同步迭代,二者双向反馈、互相驱动成长。
简单说,AI得先看懂周遭物理世界,才能摸索出精准有效的行动方案;而每一次行动踩坑、撞见意外,又会暴露世界模型里没覆盖到的认知盲区,倒逼AI更新、完善对世界的理解。认知升级后,又能支撑更高阶的动作策略优化,一环扣一环,彼此推着对方突破性能上限。
在这套框架问世之前,科研圈长期两条赛道割裂发展:一拨人埋头打磨机器人动作控制策略,另一拨人深耕高保真仿真世界模型,两边研究几乎互不互通。MirroS直接把两条独立赛道融合成统一的递归改进循环,让认知建模和动作优化同步自我迭代。
更难得的是,这套框架不局限于单一细分行业。不管是能感知、能行动的具身机器人、数字化智能制造产线,还是全自动科学实验平台,所有需要和未知物理环境交互的智能系统,都能适配Physical RSI底层逻辑。它的目标不是解决某一个场景的细碎难题,而是为所有物理智能打造一套世界模型与执行智能协同进化的通用底层体系。
二、把翻车意外当成升级养料,八步闭环藏三层巧思
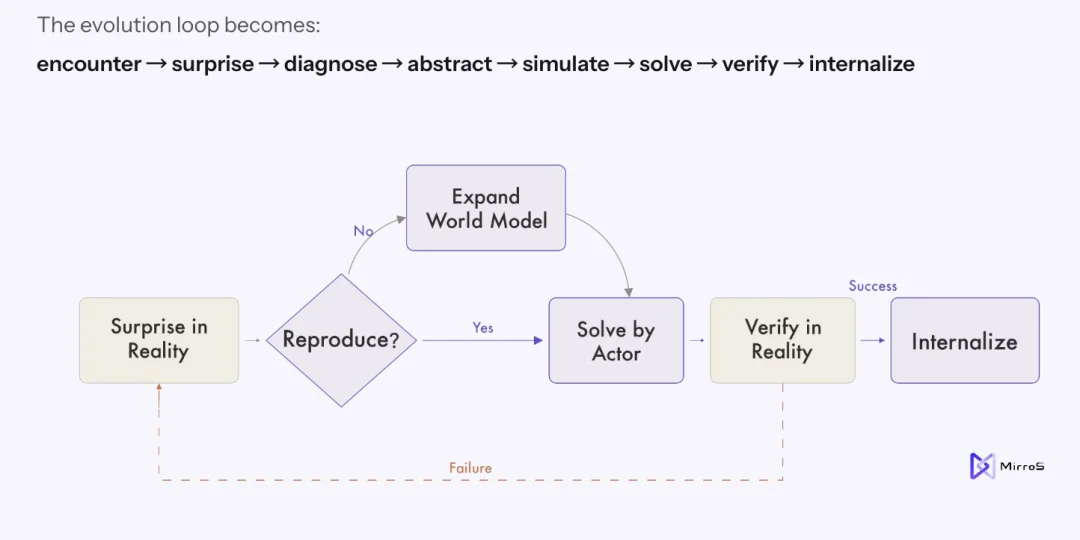
宏大的创新范式,离不开落地可行的运行机制做支撑。MirroS专门设计了一套以“突发异常(OOD事件)”为驱动力的八步完整进化循环,其中三层设计巧思格外亮眼。
第一层:出故障先修认知地图,别一门死磕操作手法
咱们拿日常开车举个接地气的例子:导航提示前方左转,开到路口却撞见道路封闭施工。这件事问题根本不在于你的驾驶技术,而是导航地图信息老旧过时。不更新地图数据,就算换一百条绕行路线,照样走不通。
Physical RSI处理意外事故也是一模一样的判断逻辑。假设机器狗行走途中被地面电缆绊倒,系统第一反应不是胡乱尝试抬腿、挪步等补救动作,而是自检核心世界模型:能不能完整复现这次绊倒的完整因果链条?电缆摆放位置、肢体接触受力、拉力传导变化、腿部运动轨迹,整套过程能不能在仿真环境里稳定复刻?
如果模型无法还原事故全过程,就代表AI对现实环境存在巨大认知空白,此时优先级最高的任务是修补、完善世界模型,业内称之为环境认知缺口;只有当失误全过程可以在仿真中稳定复现,系统才会开始搜索全新的补救动作,也就是操作技能缺口。
这套“先修正认知,再优化动作”的诊断逻辑,藏着一条底层真理:世界模型是AI认知真实世界的地图,从上线第一天起就不可能做到百分百完美,必须在一次次和现实碰撞的过程中持续校验、修补、扩充。不只是负责执行动作的Actor需要递归自我改进,用来理解世界的World Model同样要有独立的迭代循环,二者叠加在一起,才是完整闭环的Physical RSI。
第二层:认知地图支持精准修改,代码化抽象是硬性刚需
诊断出“认知地图存在错误”,下一步就要精准修正,这恰好戳中当下主流世界模型的致命短板。
如今热门的视频生成模型、3D神经场、端到端黑盒表征模型,全都类似一张模糊的位图图像:只能笼统看到“这片区域预测出错”,却没办法定位内部究竟哪条物理规则、哪段因果逻辑出现偏差,想要修正根本无从下手。
MirroS选择了一套从根源解决问题的方案:打造具备自主调试能力的智能世界模型。它不会单纯像素级复刻现实画面,而是把多模态感官采集到的经验,转化为语言层面的抽象概念,再借助代码工具,把抽象知识转换成清晰、可执行、可单独调试的因果规则。语言模块方便调取通用科学常识与生活先验,代码则把抽象认知落地成看得见、改得了的规则,哪一条预测逻辑出错,就能精准定位修改,验证后只改动局部内容,不会影响全局认知,就像矢量地图修改单条道路,整张地图依旧完整可用。
这不是单纯的技术偏好,而是实现递归自我改进的硬性门槛:如果没办法精准定位、修补认知漏洞,所谓自主进化全是空谈——修改了哪些内容、优化效果好坏,全都没有评判依据。同时这套基于抽象可执行规则的模型,跨场景迁移能力拉满,在仓库场景验证成熟的线缆接触力学规则,可以直接复用在手术室医疗机器人上。
第三层:不等意外找上门,主动出门勘探未知边界
倘若AI只会被动等待意外翻车才更新认知,进化速度完全靠运气,提升效率低到离谱。
MirroS规划的完整研究路线分为两大方向:前三项研究主攻“意外发生后如何补救、修补认知盲区”,而主动探测未知领域,才是整套系统从被动救火,升级为自主驱动进化的核心开关。
系统需要自主感知自身知识边界在哪里,主动设计对照实验,主动奔赴从未接触过的陌生区域开展勘探。再回到开车的类比:普通AI是遇上封路才临时更新地图,而搭载Physical RSI的智能体,会主动前往地图未标注的小路提前测绘,提前补齐缺失信息。
至此完整进化闭环彻底闭合:遭遇现实异常→定位故障根源→抽象梳理因果逻辑→仿真推演复现过程→求解最优应对方案→现实场景落地实测→验证优化效果→内化成通用经验。
每完整跑完一轮循环,AI收获的不只是单一事故的解决办法,更是一套完整处理未知问题的标准化流程:识别认知盲区、修正世界模型、优化执行动作、实地校验效果。海量经验持续沉淀、提炼复用后,会持续加速Actor和世界模型的迭代速度,系统处理第一百次突发状况的效率,会远远高于第一次,稳稳吃下经验复利。
三、数字自进化赛道内卷白热化,物理世界才是AI下一个增长蓝海
递归自我改进(RSI)早已脱离纸上谈兵的概念阶段,整个行业都在重金布局加码。田渊栋离开Meta创办递归超级智能公司,Ilya Sutskever主导的SSI项目拿到英伟达长期战略合作,Jeff Dean近期带队多名谷歌核心研究员成立Discovery Loop,目标打造自动化科学实验完整闭环,ICLR 2026甚至专门开设RSI专题论坛集中研讨。
从学术界到产业界,行业共识高度统一:让AI实现递归自我改良,是通往下一代高阶智能的核心路径。
但目前所有成熟落地成果,几乎全部局限在纯数字领域:自动改写代码、迭代大模型权重、全自动仿真对照实验。可业内已经形成统一判断,纯文本、纯数字智能的性能增长边际正在持续收窄,想要让AI迎来量级跨越式突破,必须攻克物理世界感知交互这道大关。
只依靠模型出厂前海量训练堆砌出来的泛化能力远远不够,AI部署到真实场景之后,必须拥有持续自学、自主进化的能力,这也是一定要把RSI自我改进逻辑延伸到物理现实的根本原因。
数字端AI自我迭代的赛道已经完全跑通,MirroS并没有否定现有数字RSI成果,而是将数字空间中涌现的自主智能逻辑,拓展到能够感知、推理、动手交互的真实物理世界当中。
这条路远比纯数字自进化更难走,充斥着无数无法预判的未知变数,但MirroS偏偏选择从这片尚未开垦的全新领域开启探索。
未来我们见到的工业机器人、智能工厂、全自动科研设备,将不再是出厂定型、越使用反应越迟钝的固定程序,而是能在真实环境里不断发掘未知、修正自身认知、持续变强的全新一代物理智能。